ToolBottleneckBench解説:AIエージェントはどこでつまずくのか
ツールが増えると、AIエージェントはなぜ失敗するのか。ToolBottleneckBenchの4種類の負荷、completion予算への介入、失敗ラベルと終了理由の違いを、3つの図で解説します。
 AI generated
David
くらちゃんと、その中核技術であるData Brainの開発を進める中で、AIエージェントのツール利用をどう評価するかに関心を持ちました。本稿では、この問題を扱う論文 ToolBottleneckBench: Measuring Tool-Agent Performance under Controlled Pressures and Fixed Harness Budgets を取り上げ、研究の問い、実験設計、主要な結果を順に解説します。
問い:成功率は、何の能力を測っているのか
ツールを使うAIエージェントは、答えを文章にするだけでなく、必要なツールを選び、結果を読み、次の操作へ進みます。この一連の処理には、モデルの推論能力だけでなく、提示するツールや応答形式、token予算、呼び出し回数の制限も関わります。
論文が着目するのは、タスクの成功率には、モデルと実行環境の両方が反映されるという点です。ここでいう実行環境は、モデルへの入力、ツール実行、各種制限、終了条件を管理する仕組みで、論文では harness と呼ばれています。
たとえばツールを増やして成功率が下がったとき、選択が難しくなったのでしょうか。それとも、選択を終える前に応答が打ち切られたのでしょうか。成功・失敗の集計だけでは、この違いを区別できません。ToolBottleneckBenchは、条件をそろえた比較と終了理由の記録によって、この問題を調べます。§1・§3
実験設計:4種類の負荷を切り分ける
主評価の対象は、12種類の業務意図に属する36のタスク族と、21のモデル・サービス構成です。構成にはモデルだけでなく、提供経路やツール呼び出し方式も含まれます。同じタスク族の重要な事実と目標を固定し、比較する条件の間で負荷を変えます。
負荷は4種類です。カタログ規模Rは、検索器が必要なツールを取り出せるかを調べます。V・W・Dは、モデルに届いた後のメニュー、手順、返却データの表現を調べます。§3・表1
図1|論文の実験設計を簡略化した図。Rは検索段階、V・W・Dはモデルが処理する条件を対象とします。対応する条件を比較し、組み合わせの効果も検証します。図は§3と表1に基づき作成。
| 負荷 | 変更する条件 | 読み取る際の注意 |
|---|---|---|
| R:登録カタログ | 32・512・2,048ツール。検索結果は16候補 | 登録数と、モデルに見せる数は別。必要なツールが届いたかを測る。 |
| V:可視メニュー | 8・32・128個のツール定義 | 必要な操作ツールは常に含める。候補が増えたときの影響を調べる。 |
| W:ワークフロー | 主実験の最小読み取り呼び出しを2・4・6回へ | 手順数に加え、依存関係と証拠の分散も変わる複合的な負荷。 |
| D:返却形式 | raw・compact・typed・linked | 同じ事実を異なる構造で表す。compactも、この実装ではrawより大きい。 |
成功判定には、答えだけでなく、正確な証拠集合、手順、許可された状態変更、予算など、9つの要件をすべて満たす VTS を使います。部分点はありません。登録カタログRの実験は、必要なツールが検索されたかを含めた別の成功指標で評価します。§3.3・付録A–B
主な予算は、1回のモデル要求のcompletion上限が 1,024 token、1タスク全体が 128,000 token、ツール呼び出し上限が そのタスクの最小必要回数+2回です。completionはモデルが生成する応答の予算で、提供元によっては内部の推論tokenも含みます。同じ名目上限でも、すべての構成で同じ使われ方になるとは限りません。
結果1:可視メニューの拡大で、明確な損失が出る
主実験では、可視ツールを8個から128個へ増やすと、VTSは平均 12.3ポイント低下しました。95%信頼区間は−14.6〜−9.9ポイントで、36タスク族のうち34で低下しています。§5.1・図2
この値は routed-menu 条件の結果です。最初のツール実行後に、正解の操作ツール情報を使ってメニューを絞る、理想的な情報を利用した参照条件になっています。メニュー全体を最後まで見せ続ける条件では、差は −17.5ポイントでした。
一方、主実験のワークフロー負荷をlowからhighへ増やした差は +0.8ポイント[−1.2, +2.8] で、全構成をまとめた明確な効果は検出されませんでした。構成ごとの結果には大きなばらつきがあり、「手順が増えても問題ない」という結論にはなりません。
返却形式の効果は比較的小さく、compactはrawに対して−3.7ポイントでしたが、業務意図単位の別の検定では、多重比較補正後に支持されませんでした。typedとlinkedにも明確な効果は検出されていません。したがって、主実験で最も明確に現れた負荷は、可視メニューの拡大です。
結果2:その損失の多くは、単発応答の上限と関わる
大きなメニューで失敗したからといって、必ずしも誤ったツールを選んだとは限りません。128ツール条件でcompletion上限に達した411実行のうち、391実行は最初のツール呼び出しより前に終了していました。
ただし、打ち切り率と成功率の相関だけでは、上限の影響を切り分けられません。そこで研究では、同じ構成のまま、completion上限を 1,024から16,384 token に増やす介入を行います。タスク全体の予算と呼び出し回数の上限は変えず、各条件を2回ずつ実行しました。§5.2・付録E.1
打ち切りが多い 6構成では、128ツールと8ツールの成功率差が −43.7から−2.7ポイントへ縮小しました。低い上限で30.6〜69.8%だった128ツール条件の打ち切り率は、高い上限では全6構成で1.4%以下になっています。
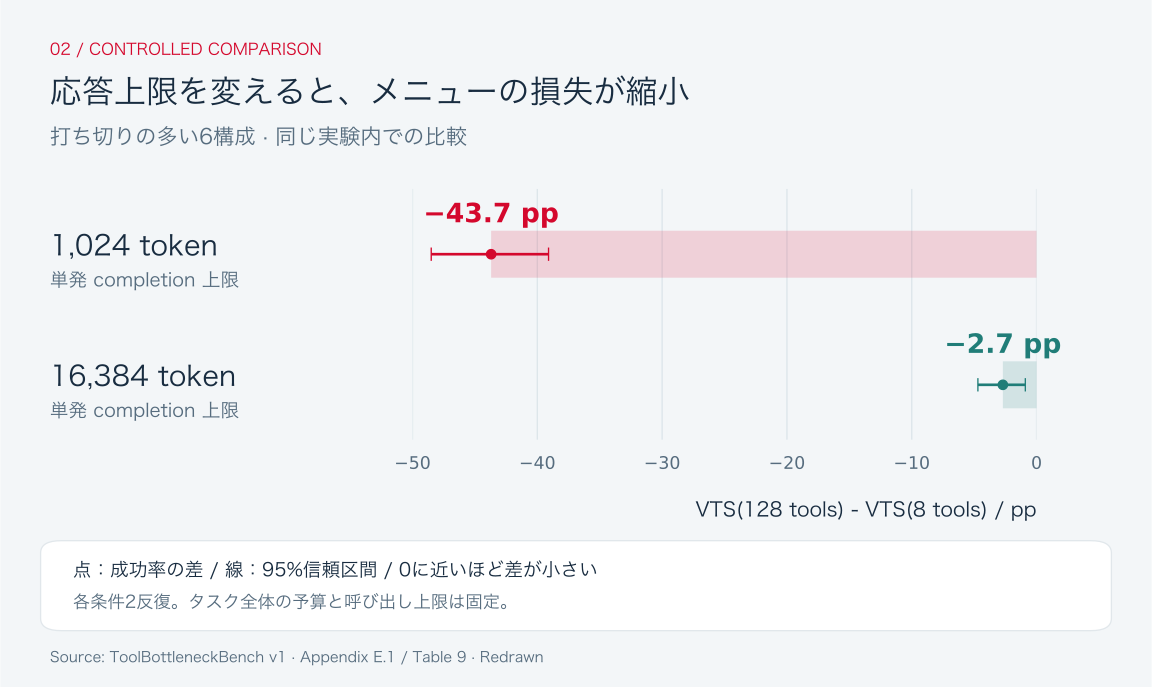
図2|表9から再作図。横軸はVTS(128ツール)−VTS(8ツール)、単位はパーセントポイント(pp)。絶対的な成功率ではありません。線は95%タスク族クラスタbootstrap信頼区間。対象は打ち切りの多い6構成であり、主実験の21構成全体の値とは区別します。
この介入は、対象となった6構成では、completion上限がメニュー損失の大部分を説明することを支持します。ただし、高い上限でも小さな損失は残ります。また、論文には打ち切りが少なくても大きなメニュー損失を示す構成があり、すべての失敗を予算に帰属させることはできません。
結果3:失敗ラベルは、原因そのものではない
評価器は9つの要件を順番に確認し、最初に満たされなかったものをラベルにします。この仕組みのため、selection failureという表示が「誤ったツールを選んだ」ことを意味するとは限りません。
実際に、849件の選択失敗ラベルはすべてツール呼び出しゼロ回の実行に付いていました。そのうち 838件はcompletion上限で終了しています。選択を間違えたというより、選択の要件を満たすところまで進めなかった実行が含まれているのです。§5.3・表3
図3|最初の未達要件と、実行の終了理由は異なる観測です。§5.3と表3に基づく解説図。ラベルだけで原因を確定することはできません。
精密に採点された20,408実行のうち、3,725件が失敗しました。その失敗の 91.5% は実行枠組みの制限で終了しています。この値には、残りの呼び出し回数では完了できないと判断する早期停止を含みます。それを除くと 78.7% です。
分母は失敗した実行です。また、制限に達したことが、そのまま実行基盤の不具合を意味するわけでもありません。モデルが余分な手順を選び、予算を使い切る場合もあります。論文が区別するのは、どの要件を満たせなかったか、どの制限で終わったか、なぜそこに至ったかという3つの問いです。
修復実験:どの部分を変えると改善するのか
論文は負荷の測定に加え、ツールの渡し方や実行の担い手を変える修復も比較します。§5.4・図4
接続先を先に選ぶ検索。登録ツールが2,048個ある条件で、接続先を選んでからツールを検索すると、必要なツールの可用率は 19.4%から77.8% に上がりました。これは検索段階の可用率であり、最終的なタスク成功率とは異なります。モデルに依存しない検索器がツールを落とす場合、後段のモデルを切り替えても、その欠落は変わりません。付録G
公開されたリンクをたどる制御プログラム。別の修復では、レコードに含まれる「次のレコード」へのリンクを、モデルの代わりにプログラムがたどります。構造検証用の24種類の業務意図・17構成の30回呼び出し条件で、成功率はモデル実行の 0% に対して 96.6% でした。平均29.9回の実行のうち28.7回をプログラムが担当しています。結果は実行の分担を変えた効果であり、モデル自体の長手順能力が向上したことを示しません。付録F・表10
追加のプロンプト説明。ワークフローやインターフェースについて説明を加える2つの修復では、明確な改善は検出されませんでした。ただし、そもそも検出可能な負荷損失がなかった条件での比較です。プロンプト調整一般の有効性を否定する結果ではありません。
修復とモデル変更の優劣も条件によって変わります。公開情報だけを使う別の開発試験では、特定の構成への切り替えが 99.0% の成功率を記録し、公開情報による各修復を上回りました。論文全体を「実行環境を直せばモデル変更より常に有利」と読むことはできません。付録J・表13
結果を読むうえでの限界
実験は合成企業タスク、固定された英語プロンプト、厳密な全条件一致の採点で構成されています。主実験の多くの構成・条件は1回ずつの実行で、予算介入も高い上限は1水準です。タスク全体の予算や呼び出し回数の制限を広く変えた実験ではありません。
主実験のrouted-menuは正解のツール情報を利用しており、そのまま実環境のルーターとして扱うこともできません。また、別の30回呼び出し実験で成功率が0%になったのは、固定された予算を使い切る条件でした。「AIは30ステップを実行できない」という一般的な能力限界を示したものではありません。Limitations・付録F
外部環境のToolSandboxでは、全ツールを見せたときの完全成功率の差は −2.9ポイント[−7.0, +0.5] で、明確な低下は検出されませんでした。よりはっきり現れたのはtoken消費の増加です。この違いは、メニューの効果を別の環境へそのまま一般化できないことを示しています。付録K・表14
この論文の貢献
ToolBottleneckBenchは、ツールを使うAIの成功率を、負荷条件と実行予算を明示して読み解くためのベンチマークです。可視メニューの拡大による損失を測り、その一部を予算への介入で切り分け、失敗ラベルと終了理由の違いを示しました。
成功率はモデルと実行環境の組み合わせに対する測定です。論文の中心的なメッセージは、その数値を比較するときに、見せたツール、与えた予算、実際に終了した理由も併せて扱う必要がある、ということです。
原論文
Zichuan Xu, Yuyang Dong, Makoto Onizuka, Chuan Xiao. ToolBottleneckBench: Measuring Tool-Agent Performance under Controlled Pressures and Fixed Harness Budgets. arXiv:2610.21098v1, 2026-10-15. 論文 · PDF · 研究コード。論文のライセンスはCC BY 4.0。
本稿はプレプリントv1の解説です。数値は論文の報告値であり、独立した再実験は行っていません。図1・3は原論文に基づく解説図、図2は表9からの再作図です。